robots.txt nasıl yazılır? E-ticaret siteleri için örnekler
robots.txt, sitenin kök dizininde duran ve arama motoru tarayıcılarına sitenin hangi bölümlerini taramamaları gerektiğini söyleyen düz bir metin dosyasıdır. Birkaç satırlık bu dosya, binlerce sayfalık bir e-ticaret sitesinde Google’ın zamanını satış getiren sayfalara yönlendirmenin en etkili araçlarından biridir. Yanlış yazılmış tek bir satır ise sitenin önemli bir bölümünü Google’a kapatabilir. Yani küçük ama dikkat isteyen bir dosya.
robots.txt neyi yapar, neyi yapmaz?
robots.txt taramayı kontrol eder. Googlebot bir adresi ziyaret etmeden önce bu dosyaya bakar ve o adrese izin verilip verilmediğini kontrol eder.
Ama robots.txt bir sayfanın dizine girmesini tek başına engellemez. Başka bir siteden link alan ve robots.txt ile engellenmiş bir sayfa, Google tarafından içeriği okunmadan yalnızca adresiyle dizine eklenebilir. Bu yüzden “bu sayfa arama sonuçlarında görünmesin” diyorsanız doğru araç noindex etiketidir. Burada sık yapılan bir hata var: bir sayfaya noindex ekleyip aynı sayfayı robots.txt ile de engellemek. Google sayfayı tarayamadığı için noindex etiketini hiç görmez.
Kısacası, robots.txt “buraya girme” der, noindex ise “buraya girebilirsin ama dizine alma” der.
Temel kurallar
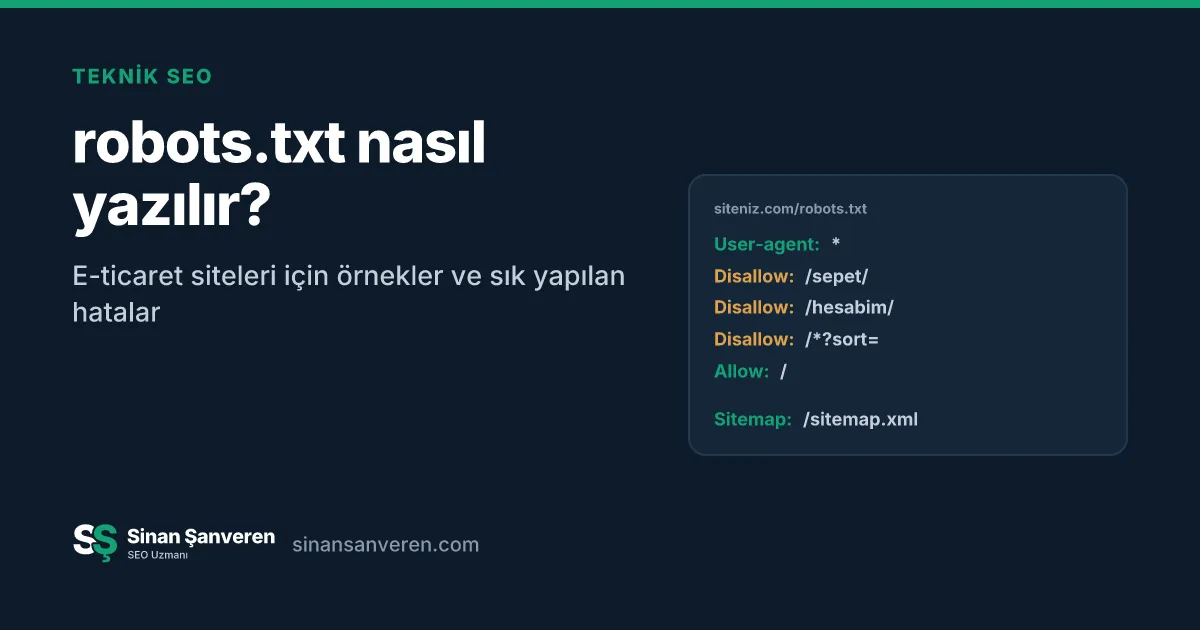
Bir robots.txt dosyası birkaç basit komuttan oluşur.
User-agent: *
Disallow: /sepet/
Disallow: /hesabim/
Allow: /

Sitemap: https://www.siteniz.com/sitemap.xml
User-agent kuralın hangi tarayıcı için geçerli olduğunu söyler. Yıldız (*) tüm tarayıcılar demektir. Googlebot yazarsanız kural yalnızca Google’ın tarayıcısı için geçerli olur.
Disallow taranmasını istemediğiniz yolu belirtir. Disallow: /sepet/ dediğinizde /sepet/ ile başlayan tüm adresler engellenir.
Allow engellenen bir alanın içinde istisna tanımlamak için kullanılır. Örneğin bir klasörün tamamını engelleyip içindeki tek bir dosyaya izin verebilirsiniz.
Sitemap site haritanızın tam adresini gösterir. Tarayıcıların site haritasını bulmasını kolaylaştırır.
Google iki özel karakteri de destekler. Yıldız (*) herhangi bir karakter dizisi yerine geçer. Dolar işareti ($) adresin sonunu belirtir. Örneğin Disallow: /*.pdf$ sonu .pdf ile biten tüm adresleri engeller.
Bir de şunu unutmayın: robots.txt’deki yollar büyük küçük harfe duyarlıdır. /Sepet/ ile /sepet/ farklı adreslerdir.
E-ticaret siteleri için örnek
Bir e-ticaret sitesinde taranmasına gerek olmayan sayfalar genellikle bellidir: sepet, ödeme, üye hesabı, site içi arama sonuçları ve sayfanın içeriğini değiştirmeyen sıralama parametreleri. Tipik bir örnek şöyle olabilir:
User-agent: *
Disallow: /sepet/
Disallow: /odeme/
Disallow: /hesabim/
Disallow: /arama
Disallow: /*?sort=
Disallow: /*&sort=

Sitemap: https://www.siteniz.com/sitemap.xml
Bu örneği olduğu gibi kopyalamayın. Sitenizin adres yapısı farklı olabilir. Örneğin sizin altyapınızda sepet /cart/ adresinde olabilir ya da sıralama parametresinin adı order olabilir. Kuralları yazmadan önce sitenizde bu sayfaların gerçek adreslerine bakın.
Filtre parametreleri konusunda daha dikkatli olmak gerekiyor. “Siyah deri çanta” gibi insanların gerçekten aradığı bir filtre sayfasını robots.txt ile engellerseniz, o sayfa hiçbir zaman sıralama alamaz. Hangi filtrelerin açık kalacağına arama talebine bakarak karar verin. Bu konuyu kategori sayfası SEO rehberinde ayrıntılı anlattım.
Yapay zeka tarayıcıları
Son yıllarda robots.txt dosyalarına yeni bir grup tarayıcı girdi: yapay zeka şirketlerinin tarayıcıları. Bunlar iki gruba ayrılır.
Bir grup, yapay zeka modellerinin eğitimi için veri toplar. OpenAI’ın GPTBot’u bu gruptadır. Google da Gemini modellerinin eğitiminde içeriğinizin kullanılmasını kontrol etmeniz için Google-Extended adında ayrı bir kural adı sunar. Google-Extended’ı engellemek, sitenizin Google aramadaki görünürlüğünü etkilemez.
Diğer grup, kullanıcı bir soru sorduğunda anlık arama yapar ve cevabın altında kaynak gösterir. ChatGPT aramaları için OAI-SearchBot ve Perplexity’nin PerplexityBot’u bu gruptadır.
İçeriğinizin eğitimde kullanılmasını istemiyorsanız eğitim tarayıcılarını engelleyebilirsiniz. Arama tarayıcılarını açık bırakmak ise yapay zeka cevaplarında kaynak olarak gösterilmenizi sağlar. Bu konuyu GEO nedir? yazısında da anlattım.
En sık yapılan hatalar
Tüm siteyi engellemek
Disallow: / satırı sitenin tamamını taramaya kapatır. Bu satır genellikle geliştirme ortamından canlı siteye taşınırken unutulur. Yeni bir site yayına aldığınızda ya da tema değiştirdiğinizde robots.txt dosyasına mutlaka bir göz atın.
CSS ve JavaScript dosyalarını engellemek
Google sayfayı tarayıcıda göründüğü haliyle değerlendirir. Tema dosyalarını, CSS’i ya da JavaScript’i engellerseniz Google sayfayı eksik ya da bozuk görebilir.
Önemli sayfaları geniş bir kuralla engellemek
Disallow: /urun gibi bir kural yalnızca /urun/ klasörünü değil, /urunler/ ve /urun-karsilastirma/ gibi /urun ile başlayan her adresi engeller. Kuralı yazarken sonuna eğik çizgi koymak bu tür kazaları önler.
Kaldırılmış bir sayfayı robots.txt ile “silmeye” çalışmak
Artık var olmayan sayfalar için robots.txt’ye kural eklemek gerekmez. Bu sayfaların 404 ya da 301 yönlendirme ile doğru cevap vermesi yeterlidir. Ayrıntılar için stokta olmayan ürünler yazısına bakabilirsiniz.
Değişiklikten sonra kontrol
robots.txt’de bir değişiklik yaptıktan sonra Search Console’daki robots.txt raporuna bakın. Bu rapor Google’ın dosyanızı en son ne zaman okuduğunu ve okurken bir sorunla karşılaşıp karşılaşmadığını gösterir. Belirli bir adresin engellenip engellenmediğini görmek için de URL Denetleme aracını kullanabilirsiniz.
Google’ın tarama sorunlarıyla ilgili uyarıları görüyorsanız, örneğin önemli sayfalar “Bulundu, şu anda dizine eklenmedi” listesinde bekliyorsa, sorun robots.txt’den çok sitenin genel yapısında olabilir. Bu durumda tarandı ama dizine eklenmedi yazısı ve bir teknik SEO denetimi daha geniş bir resim sunar.
Sık Sorulan Sorular
robots.txt ile bir sayfayı Google'dan kaldırabilir miyim?
Hayır. robots.txt yalnızca taramayı engeller. Başka sitelerden link alan bir sayfa, içeriği taranmasa bile adresiyle birlikte dizine girebilir. Bir sayfanın arama sonuçlarında görünmemesini istiyorsanız noindex kullanın ve o sayfayı robots.txt ile engellemeyin, çünkü Google noindex etiketini ancak sayfayı tarayabilirse görür.
robots.txt dosyası nerede olmalı?
Sitenin kök dizininde, siteniz.com/robots.txt adresinde. Alt klasörlere konan robots.txt dosyaları dikkate alınmaz. Her alt alan adının kendi robots.txt dosyası olması gerekir.
robots.txt'de crawl-delay kullanmalı mıyım?
Google bu kuralı desteklemez, dosyanızda olsa bile Googlebot için bir etkisi olmaz. Google'ın tarama hızı sunucunuzun yanıt süresine göre kendiliğinden ayarlanır.
Yapay zeka tarayıcılarını engellemeli miyim?
Bu bir tercih meselesi. Eğitim için veri toplayan tarayıcılarla, anlık arama yapıp kaynak gösteren tarayıcılar farklıdır. İçeriğinizin model eğitiminde kullanılmasını istemiyorsanız bile arama tarayıcılarını açık bırakmak, yapay zeka cevaplarında kaynak gösterilmenizi sağlar.