Noindex etiketi nedir? Ne zaman kullanılır, nasıl kontrol edilir?
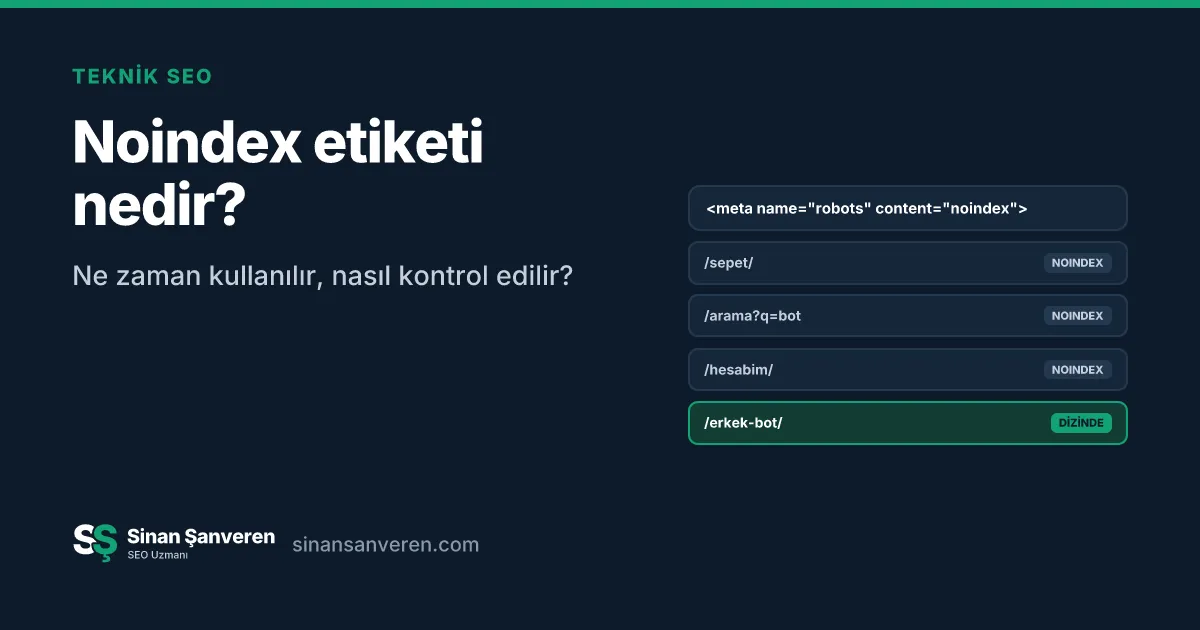
Noindex, bir sayfanın arama motorlarının dizinine eklenmemesini ve arama sonuçlarında gösterilmemesini sağlayan bir yönergedir. Sayfanın HTML’indeki <head> bölümüne bir meta etiketi olarak ya da sunucunun HTTP yanıt başlığına X-Robots-Tag olarak eklenir. Sayfa sitede açık kalır, ziyaretçiler ona ulaşabilir, ama Google’da görünmez. Noindex’in çalışması için Google’ın sayfayı tarayabilmesi gerekir. Bu yüzden robots.txt ile engellenmiş bir sayfaya verilen noindex işe yaramaz.
Noindex, SEO’nun en güçlü ama en tehlikeli araçlarından biri. Doğru sayfalarda kullanıldığında dizini temiz tutar. Yanlış sayfaya eklendiğinde ise bir kategori, bir ürün grubu ya da bütün site Google’dan sessizce kaybolur. Bu yazıda nasıl ekleneceğini, hangi sayfalarda kullanılacağını ve yanlışlıkla eklenen noindex’in nasıl bulunacağını anlatıyorum.
Noindex nasıl eklenir?
Meta etiketi
En yaygın yöntem, sayfanın <head> bölümüne bir meta etiketi eklemektir:
<meta name="robots" content="noindex">robots yerine googlebot yazılırsa kural yalnızca Google’ın tarayıcıları için geçerli olur. Çoğu sitede buna gerek yoktur.
X-Robots-Tag
PDF dosyaları, görseller ve videolar gibi HTML olmayan dosyalarda meta etiketi kullanılamaz. Bu dosyalar için sunucu, yanıtın başlığına şunu ekler:
[X-Robots-Tag](/seo-sozlugu/#x-robots-tag): noindexGoogle’a göre iki yöntemin etkisi aynıdır. Hangisinin kullanılacağı sayfanın türüne ve sitenin altyapısına bağlıdır.
Altyapıların ayarları
E-ticaret altyapılarının ve içerik yönetim sistemlerinin çoğu, sayfa ya da sayfa türü bazında “arama motorlarında gösterme” gibi bir ayar sunar. Bu ayar arka planda meta etiketini ekler. Ayarı kullandıktan sonra sayfanın kaynak kodunda etiketin gerçekten oluştuğunu kontrol edin.
Noindex, robots.txt ve canonical farkı
Bu üç araç sık karıştırılır, ama farklı işler yapar.
robots.txt, tarayıcının bir adresi taramasını engeller. Dizine eklenmesini engellemez. Başka sitelerden link alan ve robots.txt ile engellenmiş bir sayfa, içeriği taranmadan da adresiyle birlikte arama sonuçlarında görünebilir. Google robots.txt dosyasındaki noindex kuralını da desteklemez. Ayrıntıları robots.txt rehberinde anlattım.
Noindex, taramaya izin verir ama dizine eklemeyi engeller. Bir sayfanın Google’da görünmemesini istiyorsanız doğru araç budur.
Canonical etiketi, birbirine çok benzeyen sayfalardan hangisinin asıl sayfa olduğunu söyler. Kopya sayfaların sinyallerini asıl sayfada toplar. Noindex’ten farkı, sayfayı tamamen dizin dışına itmek yerine asıl sürüme yönlendirmesidir.
Basit bir kural: Sayfa başka bir sayfanın kopyasıysa canonical, dizinde olmasının hiçbir amacı yoksa noindex, taranmasının bile gereği yoksa robots.txt.
Hangi sayfalarda kullanılır?
Noindex genellikle şu sayfalarda kullanılır:
- Site içi arama sonuç sayfaları. Bunu site içi arama sayfaları yazısında anlattım.
- Arama talebi olmayan filtre ve sıralama kombinasyonları
- Sepet, ödeme, üye hesabı, teşekkür sayfaları
- Çok az içerikli etiket, yazar ve tarih arşivleri
- Yalnızca birkaç ürünü olan marka sayfaları
- Test ve önizleme sayfaları
Ama noindex her sorunun çözümü değildir. Zayıf içerikli bir sayfa önemli bir aramayı hedefliyorsa, noindex vermek yerine sayfayı iyileştirmek ya da benzer bir sayfayla birleştirmek daha iyi sonuç verir.
Sık yapılan hatalar
Yayına alınırken unutulan noindex
Yeni bir site ya da yenilenen bir tasarım geliştirilirken test ortamına noindex verilir. Site yayına alındığında bu ayar kaldırılmayı unutulur ve site haftalarca Google’da görünmez. Yeni bir siteyi ya da tasarımı yayına aldığınız gün, ana sayfanın ve birkaç önemli sayfanın kaynak kodunda noindex aratın.
Sayfalanmış kategorilere noindex
Kategori sayfalarının ikinci ve sonraki sayfalarına noindex vermek yaygın bir uygulamadır. Ama bu sayfalar, eski ürünlerin keşfedilmesini sağlayan sayfalardır. Google’dan bir çalışanın açıklamalarına göre uzun süre noindex kalan sayfalardaki linkler de zamanla takip edilmeyebilir. Sayfalanmış kategoriler genellikle dizinde kalmalı ve her biri kendi adresini canonical olarak göstermelidir. Bunu kategori sayfası SEO rehberinde anlattım.
Noindex ile robots.txt’yi birlikte kullanmak
Bir sayfaya noindex verip aynı anda robots.txt ile taramasını engellemek, Google’ın noindex etiketini hiç görememesi demektir. Sayfa dizinde kalabilir. Dizinden çıkmasını istediğiniz sayfaları önce noindex ile çıkarın, sonra gerekirse taramalarını engelleyin.
Site haritasında noindex sayfa
Site haritası, Google’a “bu sayfaları dizine ekle” der. Noindex ise tam tersini söyler. Site haritasındaki sayfaların hiçbirinde noindex olmamalıdır. Bunu XML site haritası yazısında anlattım.
JavaScript ile eklenen ya da kaldırılan noindex
Bazı siteler noindex etiketini sayfa yüklendikten sonra JavaScript ile ekler ya da kaldırır. Google’ın JavaScript dokümanına göre Google, sayfanın ilk HTML’inde noindex görürse sayfayı işlemeyebilir ve JavaScript’i hiç çalıştırmayabilir. Yani ilk HTML’de noindex olan bir sayfadan JavaScript ile etiketi kaldırmak işe yaramaz. Noindex kararı sunucu tarafında, sayfanın ilk HTML’inde verilmelidir. Bunu JavaScript SEO yazısında anlattım.
Şablon hataları
Bir altyapı güncellemesi ya da şablon değişikliği, noindex’i bir sayfa türünün tamamına ekleyebilir. Bir sabah bütün ürün sayfalarının ya da bütün kategori sayfalarının dizinden düşmeye başladığını görürsünüz. Bu tür hataları erken fark etmek için düzenli kontrol gerekir.
Noindex nasıl kontrol edilir?
Tek bir sayfayı kontrol etmek için sayfanın kaynak kodunu açıp noindex aratın. HTTP başlığındaki X-Robots-Tag kaynak kodunda görünmez. Bunu görmek için tarayıcının geliştirici araçlarındaki Ağ sekmesini ya da bir HTTP başlığı kontrol aracını kullanın.
Search Console’daki URL denetimi aracı, Google’ın sayfayı son taradığında noindex görüp görmediğini ve dizine ekleme durumunu gösterir. Sayfalar raporu ise noindex nedeniyle dizine eklenmeyen bütün sayfaları listeler. Bu listeyi ayda bir kontrol edin ve içinde olmaması gereken bir sayfa olup olmadığına bakın.
Sitenin tamamı için Screaming Frog gibi bir tarama aracı, noindex olan bütün sayfaları listeler. Önemli bir altyapı güncellemesinden sonra siteyi taramak, şablon hatalarını Google fark etmeden yakalamayı sağlar.
Noindex ekledikten sonra sayfanın Google’dan çıkması, Google’ın sayfayı tekrar taramasına bağlıdır. Google’a göre az taranan sayfalarda bu aylar sürebilir. Acil durumlarda Search Console’daki URL denetimi aracıyla yeniden tarama isteyebilirsiniz.
Sık Sorulan Sorular
Noindex etiketi ne işe yarar?
Noindex, bir sayfanın arama motorlarının dizinine eklenmemesini ve arama sonuçlarında gösterilmemesini sağlar. Sayfa sitede açık kalır ve ziyaretçiler ona ulaşabilir, ama Google'da görünmez.
robots.txt ile noindex verilebilir mi?
Hayır. Google, robots.txt dosyasındaki noindex kuralını desteklemez. Noindex'in çalışması için sayfanın taranabilir olması ve etiketin sayfanın kendisinde ya da HTTP yanıt başlığında bulunması gerekir.
Noindex verdiğim sayfa ne zaman Google'dan çıkar?
Google'ın sayfayı tekrar taraması gerekir. Önemli sayfalarda bu birkaç gün sürebilir, az taranan sayfalarda ise aylar alabilir. Search Console'daki URL denetimi aracıyla yeniden tarama isteyerek süreci hızlandırabilirsiniz.
Noindex ile canonical aynı sayfada kullanılabilir mi?
Kullanılmamalı. Canonical etiketi 'bu sayfanın asıl sürümü şu sayfa' der, noindex ise 'bu sayfayı dizine ekleme' der. İkisi birlikte Google'a çelişkili bir sinyal gönderir. Kopya sayfalarda canonical, dizinde olmasını istemediğiniz sayfalarda noindex kullanın.